Media pelota de pimpón sobre cada ojo, una luz roja apuntando a la cara y unos auriculares con un siseo constante. El montaje parece una broma de laboratorio de los años setenta y, sin embargo, es el procedimiento que produjo el conjunto de resultados más discutido de toda la investigación sobre percepción anómala.
La discusión no ha sido marginal. Se libró en revistas de psicología de circulación general, con estadísticos de ambos bandos revisando las mismas bases de datos, y produjo algo raro en este terreno: un acuerdo escrito entre un crítico y un defensor sobre qué condiciones tendría que cumplir un experimento para que su resultado contara.
Lo que sigue ordena lo que se hizo, lo que salió y por qué dos metaanálisis sobre el mismo procedimiento pudieron llegar a conclusiones opuestas sin que ninguno de los dos estuviera mal calculado.
Las respuestas cortas, antes del detalle
- Qué es: un procedimiento de estimulación sensorial homogénea en el que un receptor describe imágenes mentales mientras un emisor mira un objetivo.
- Probabilidad de acierto por azar: el veinticinco por ciento, porque al final se elige entre cuatro candidatos.
- Qué dieron las series positivas: tasas en torno a un tercio, es decir, unos pocos puntos por encima del azar.
- Qué dio la revisión de 1999: ningún efecto distinguible del azar en la tanda de estudios posterior.
- Dónde está el desacuerdo: en qué estudios entran en cada recuento y en cuánta variabilidad se acepta antes de sumarlos.
- Qué falta: réplicas con registro previo del protocolo y del análisis, hechas por equipos con expectativas opuestas.
¿En qué consiste el experimento ganzfeld?
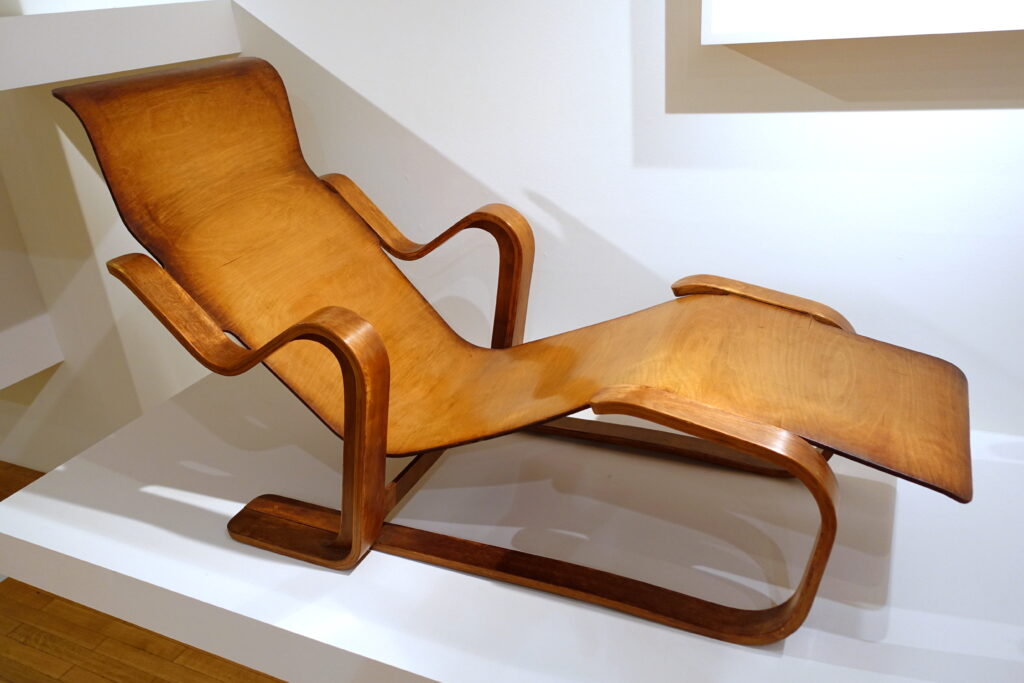
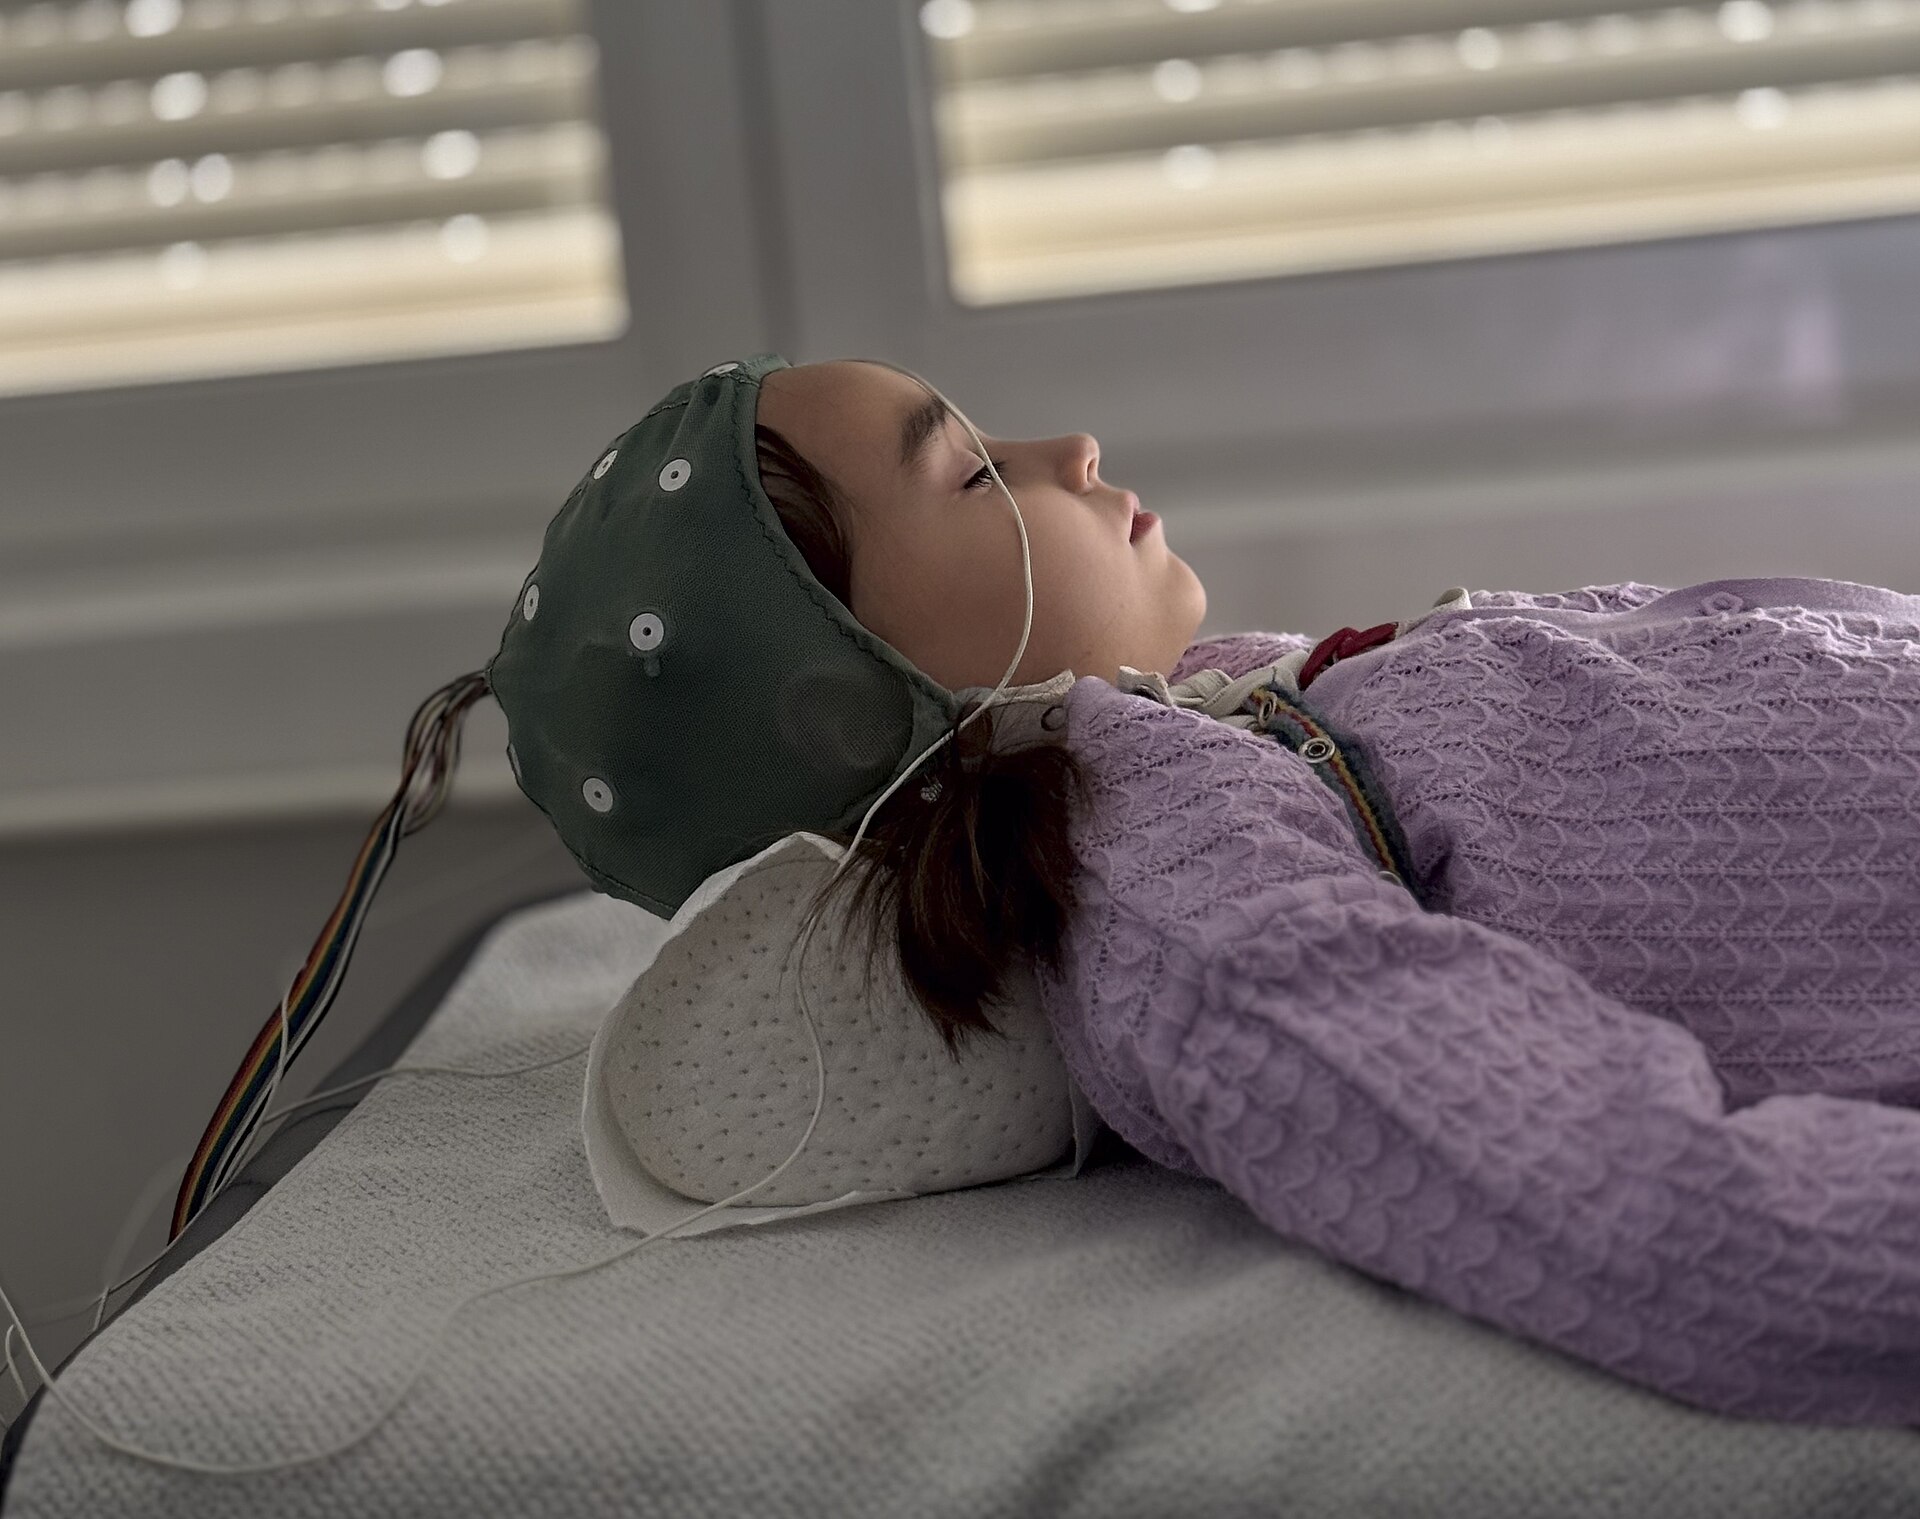
El receptor se instala en una sala aislada acústicamente, en un sillón reclinable. Se le colocan sobre los ojos dos medias esferas translúcidas y se ilumina su cara con luz roja difusa, de modo que el campo visual queda reducido a un rosa uniforme sin bordes ni texturas. Por los auriculares suena ruido rosa, un siseo continuo sin estructura.
Durante media hora aproximadamente, el receptor va diciendo en voz alta todo lo que le pasa por la cabeza: imágenes, escenas, sensaciones. Un experimentador que no conoce el objetivo lo graba o lo transcribe.
Mientras tanto, en otra sala aislada, un emisor mira una imagen o un vídeo seleccionado al azar entre un conjunto y trata de transmitirlo. Al terminar, se presentan al receptor cuatro opciones, una de las cuales es el objetivo, y se le pide que las ordene por parecido con lo que ha descrito. Si señala la correcta, cuenta como acierto.
Hay una variante que conviene distinguir desde el principio. En algunas series no existe emisor: el objetivo se selecciona y se guarda sin que nadie lo mire, y el receptor intenta describirlo igualmente. Esa condición sirve para separar dos hipótesis distintas, la de transmisión entre personas y la de acceso directo a la información, y sus resultados no siempre se han contabilizado por separado.
¿De dónde sale la idea de tapar los sentidos?
El montaje no se inventó para esto. La estimulación homogénea del campo visual se estudiaba desde comienzos del siglo XX en psicología de la percepción, porque produce un efecto curioso: privado de bordes y contrastes, el sistema visual deja de estabilizar la imagen y el observador empieza a ver el campo como una niebla sin profundidad, con apariciones espontáneas.
De ahí se saltó a una hipótesis concreta. Si existiera algún canal de información débil, quedaría enterrado bajo el tráfico sensorial normal, del mismo modo que una conversación en voz baja se pierde en una calle con obras. Reducir el ruido de entrada sería, en esa lógica, subir la relación entre señal y fondo.
La hipótesis tiene el mérito de ser comprobable, y ese es exactamente su valor. Es una idea de laboratorio, con un protocolo, un cálculo de azar y un criterio de acierto fijado de antemano, lo que la sitúa en otro plano frente a los relatos de presentimientos y coincidencias, donde nada de eso se puede fijar.
¿Cómo se cuenta un acierto y por qué cuatro opciones?
El número de candidatos determina el azar y por eso está fijado. Con cuatro opciones, alguien que responda al buen tuntún acertará una de cada cuatro veces a largo plazo, es decir, el veinticinco por ciento. Cualquier afirmación de resultado positivo consiste en decir que una serie de sesiones dio una tasa significativamente superior a ese valor.
La magnitud de la que se habla es pequeña. Las series consideradas positivas se sitúan en torno a un tercio de aciertos, unos siete u ocho puntos por encima del azar. Con ese tamaño de efecto se necesitan muchísimas sesiones para distinguirlo del ruido, y ahí empieza el problema estadístico de todo el campo.
El juicio de parecido introduce además una variable incómoda. El receptor produce media hora de habla libre, muy rica en imágenes, y luego compara ese material con cuatro objetivos. Un texto largo y ambiguo encaja con casi cualquier cosa si se busca el encaje, que es el mecanismo que sostiene también la lectura en frío y buena parte de lo que la expectativa produce en experiencias intensas.
¿Qué dieron las primeras series?
Las primeras tandas, realizadas a mediados de los años setenta en varios laboratorios, dieron tasas por encima del azar y generaron un entusiasmo considerable dentro del campo. Se acumularon algunas decenas de estudios en pocos años y se publicaron como conjunto.
Esos primeros trabajos arrastraban, sin embargo, defectos de procedimiento que hoy nadie discute. En algunos, el propio experimentador que había estado con el receptor participaba en el juicio final. En otros, la selección del objetivo se hacía a mano y el orden de presentación de las cuatro opciones no estaba aleatorizado de forma independiente.
El más citado de esos defectos es de una simpleza desarmante: si el emisor manipula físicamente la lámina del objetivo durante media hora y luego se le entrega al receptor ese mismo juego de láminas, las marcas, dobleces o huellas pueden delatar cuál era. Se llama fuga sensorial y no requiere mala fe de nadie.
La corrección es sencilla y hoy se aplica de forma rutinaria: se preparan duplicados idénticos y sin manipular de las cuatro opciones, y el juego que se entrega para el juicio nunca es el que estuvo en la sala del emisor. Que ese detalle tardara casi una década en generalizarse dice bastante sobre cómo se construyó la base de datos temprana.
¿Qué se acordó en el debate de los años ochenta?
A mediados de los ochenta, un psicólogo crítico revisó la base de datos completa y publicó una lista de fallos de procedimiento junto con un análisis de su relación con los resultados. El principal defensor del campo respondió con su propio análisis, defendiendo que el efecto sobrevivía al descarte de los estudios defectuosos.
Lo notable vino después: ambos firmaron un documento conjunto reconociendo que los datos existentes no bastaban para decidir la cuestión y estableciendo los requisitos que debería cumplir cualquier experimento futuro. Aleatorización automática, aislamiento acústico comprobado, duplicados del objetivo para el juicio, control de la fuga sensorial y documentación completa del protocolo.
Ese acuerdo es el episodio más saludable de toda la historia del asunto. Fijó por escrito y por anticipado el criterio con el que se iba a evaluar lo que viniera, que es justo lo que rara vez ocurre en las polémicas sobre fenómenos anómalos.
¿Qué cambió el procedimiento automatizado?
La respuesta a ese acuerdo fue una serie de estudios con el proceso informatizado. Un ordenador seleccionaba el objetivo, controlaba su presentación al emisor, ordenaba al azar las cuatro opciones en el juicio y registraba la respuesta, sin que ningún experimentador conociera el objetivo en ningún momento del proceso.
Con ese montaje se ejecutaron varios centenares de sesiones a lo largo de los años ochenta. El resultado agregado volvió a situarse por encima del azar, en el entorno de un tercio de aciertos, y se publicó a comienzos de los noventa en una revista de psicología de amplia difusión, no en una publicación especializada del campo.
Aquel artículo incluía además observaciones sobre qué condiciones parecían rendir más: objetivos en vídeo por delante de imágenes fijas, receptores con formación artística, y parejas de emisor y receptor con relación previa. Esas observaciones nacieron del propio análisis de los datos, lo que las convierte en hipótesis a comprobar y no en resultados confirmados.
Ese matiz es más importante de lo que parece. Buscar en unos datos ya recogidos qué subgrupos rindieron mejor casi siempre encuentra algo, porque con suficientes divisiones alguna sale por encima por puro azar. Solo vale como resultado si se anuncia antes de recoger los datos y se comprueba en una serie nueva, y en este caso esa segunda parte no llegó a hacerse con la potencia necesaria.
¿Y el metaanálisis que no encontró nada?
A finales de los noventa, dos investigadores reunieron los estudios publicados después de aquella serie automatizada, en torno a una treintena, y calcularon el efecto conjunto. No encontraron una desviación significativa respecto del azar.
La réplica fue inmediata y se centró en la composición de la muestra. Se discutió qué estudios debían entrar, si algunos empleaban variantes del procedimiento demasiado alejadas del original y si tenía sentido sumar trabajos con protocolos tan distintos bajo la misma etiqueta.
Revisiones posteriores, con distintos criterios de inclusión y periodos más largos, han vuelto a dar resultados positivos de pequeña magnitud. El patrón se repite desde entonces: el signo del resultado depende de qué se mete en el saco, y no hay un criterio neutral aceptado por ambas partes para decidirlo.
Merece la pena señalar lo que ese vaivén no significa. No significa que unos calculen mal ni que otros oculten datos: significa que el corpus es pequeño, heterogéneo y sensible a cualquier decisión de inclusión. Un cuerpo de evidencia robusto aguanta que se le cambien los criterios sin cambiar de signo, y este no lo aguanta.
¿Por qué dos recuentos correctos dan resultados opuestos?
| Decisión del analista | Efecto sobre el resultado | Por qué es discutible |
|---|---|---|
| Periodo de estudios incluido | Alto | Los años elegidos coinciden con cambios de protocolo |
| Definición de qué cuenta como el procedimiento | Alto | Las variantes se apartan mucho del montaje original |
| Tratamiento de los estudios no publicados | Medio | No hay registro completo de los que quedaron en el cajón |
| Peso dado a la calidad metodológica | Medio | No existe escala consensuada para puntuarla |
| Modelo estadístico de agregación | Medio | Con heterogeneidad alta, la elección cambia el intervalo |
| Inclusión de series muy largas de un solo laboratorio | Alto | Un centro puede dominar el resultado global |
Ninguna de esas decisiones es un error de cálculo. Son elecciones defendibles que se toman antes de sumar nada, y su combinación explica que dos equipos honestos obtengan conclusiones contrarias de un mismo corpus.
¿Cuánto pesa el sesgo de publicación?
Es el punto que más ha condicionado la discusión. Los estudios con resultado nulo se publican menos, y en un campo pequeño donde casi todo el mundo se conoce, un experimento fallido puede simplemente no llegar nunca a redactarse.
Se han empleado los métodos habituales para estimarlo, incluido el cálculo del número de estudios negativos que harían falta para anular el efecto observado. Los defensores señalan que esa cifra resulta demasiado grande para un campo con tan pocos laboratorios activos; los críticos responden que esos métodos suponen una distribución que aquí no se cumple.
La única salida real es el registro previo: anunciar públicamente el protocolo, el tamaño de muestra y el análisis antes de empezar, de modo que el estudio conste con independencia de cómo salga. Es la práctica que ha reformado la psicología experimental en la última década y la que permitiría, por fin, comparar peras con peras.
¿Se ha replicado con registro previo?
Hay algunos intentos y son insuficientes. El campo dispone de muy poca financiación, de pocos laboratorios y de un problema de tamaño: para distinguir con solvencia un efecto de esa magnitud harían falta muchos cientos de sesiones, cada una de una hora larga, repartidas entre centros independientes.
Lo que sí existe son réplicas puntuales con resultados dispares y algún trabajo colaborativo entre equipos con posturas distintas. Ese formato, en el que quienes esperan un resultado positivo y quienes esperan un resultado nulo diseñan juntos el experimento y firman el análisis por adelantado, es el que ha resuelto otras controversias parecidas en psicología.
Mientras eso no se haga a escala suficiente, la situación es de empate técnico: hay una base de datos con una desviación pequeña y persistente, y una lista de explicaciones alternativas que ninguna medición ha descartado del todo. Es un estado bastante distinto al de los experimentos con cartas que iniciaron esta línea, cuyos fallos de barajado y de registro sí se identificaron uno a uno.
¿Qué pasa dentro del receptor durante esa media hora?
Esta parte no está en discusión y es la más sólida del asunto. La estimulación homogénea produce en pocos minutos un estado de conciencia alterado, con imágenes espontáneas vívidas, pérdida de la noción del tiempo y a veces sensación de flotación. Ocurre en prácticamente todo el mundo y no requiere ninguna hipótesis exótica.
El mecanismo tiene que ver con lo que hace un sistema perceptivo cuando se queda sin datos que procesar: baja el umbral y empieza a interpretar su propio ruido interno como si fuera señal externa. Es el mismo principio que produce imágenes en la oscuridad total, en la privación sensorial prolongada y en las fases de transición al sueño.
Ese efecto convierte el procedimiento en una herramienta útil para estudiar la generación de imágenes mentales, con independencia de que haya o no transmisión de información. Es, probablemente, su legado más seguro, y emparenta el montaje con lo que se observa en el material onírico que después se interpreta como anticipación.
Preguntas frecuentes
¿Se puede montar en casa?
El estado alterado sí se reproduce con facilidad: media pelota de pimpón por ojo, una lámpara roja y ruido de radio sin sintonizar bastan para experimentarlo. Lo que no se reproduce en casa es el experimento, que exige aislamiento acústico verificado, selección automática del objetivo y un juicio a ciegas. Sin eso solo se obtiene una experiencia perceptiva interesante.
¿El resultado depende de quién sea el receptor?
Es una de las hipótesis que salieron del análisis de los datos, no una conclusión establecida. Se ha descrito mejor rendimiento en personas con formación artística, con experiencia en meditación o con creencia previa en el fenómeno. Ninguna de esas observaciones ha sido confirmada en una réplica diseñada específicamente para comprobarla.
¿Por qué la psicología académica no se ocupa más de esto?
Por una cuestión de coste y de rendimiento esperado. Un efecto de pocos puntos porcentuales exige muestras enormes, y la mayoría de los departamentos prefiere invertir esas horas en preguntas con base teórica más firme. Las asociaciones profesionales, como la asociación estadounidense de psicología, publican material sobre criterios de calidad experimental que se aplica igual aquí que en cualquier otro campo.
¿Ha habido fraude documentado?
Ha habido casos de manipulación en la historia de la investigación sobre percepción anómala, y también en otras áreas de la psicología. En este procedimiento concreto, lo que se ha documentado son fallos de diseño y de aleatorización, no falsificación. La automatización se introdujo precisamente para que esa discusión dejara de ser posible.
¿Qué zanjaría el asunto?
Un estudio multicéntrico con registro previo, potencia suficiente, protocolo firmado por partidarios y escépticos y compromiso de publicar cualquier resultado. Nada de eso es técnicamente difícil; es caro y requiere que ambas partes acepten quedar comprometidas con el resultado. Los organismos profesionales de referencia, entre ellos la sociedad británica de psicología, publican guías de práctica investigadora que sirven de marco para un diseño así.
¿Es lo mismo que la visión remota?
No. La visión remota se desarrolló en paralelo con otro protocolo, sin privación sensorial y con objetivos geográficos en lugar de imágenes, y su evaluación siguió un camino administrativo distinto. Comparten el problema del juicio de parecido entre una descripción libre y un objetivo, que es la parte más delicada de ambos.